Profielen
Bedrijfsprofielen naast elkaar: aanwezigheid in zoekmachines, of AI-assistenten de site kunnen lezen, content, gestructureerde data en technologie.
Profielen zet één concurrent naast jou, signaal voor signaal: hoe hij het doet in zoekmachines, of AI-assistenten zijn site mogen lezen, hoe groot en vers zijn content is, welke gestructureerde data hij publiceert en waarmee zijn site is gebouwd.
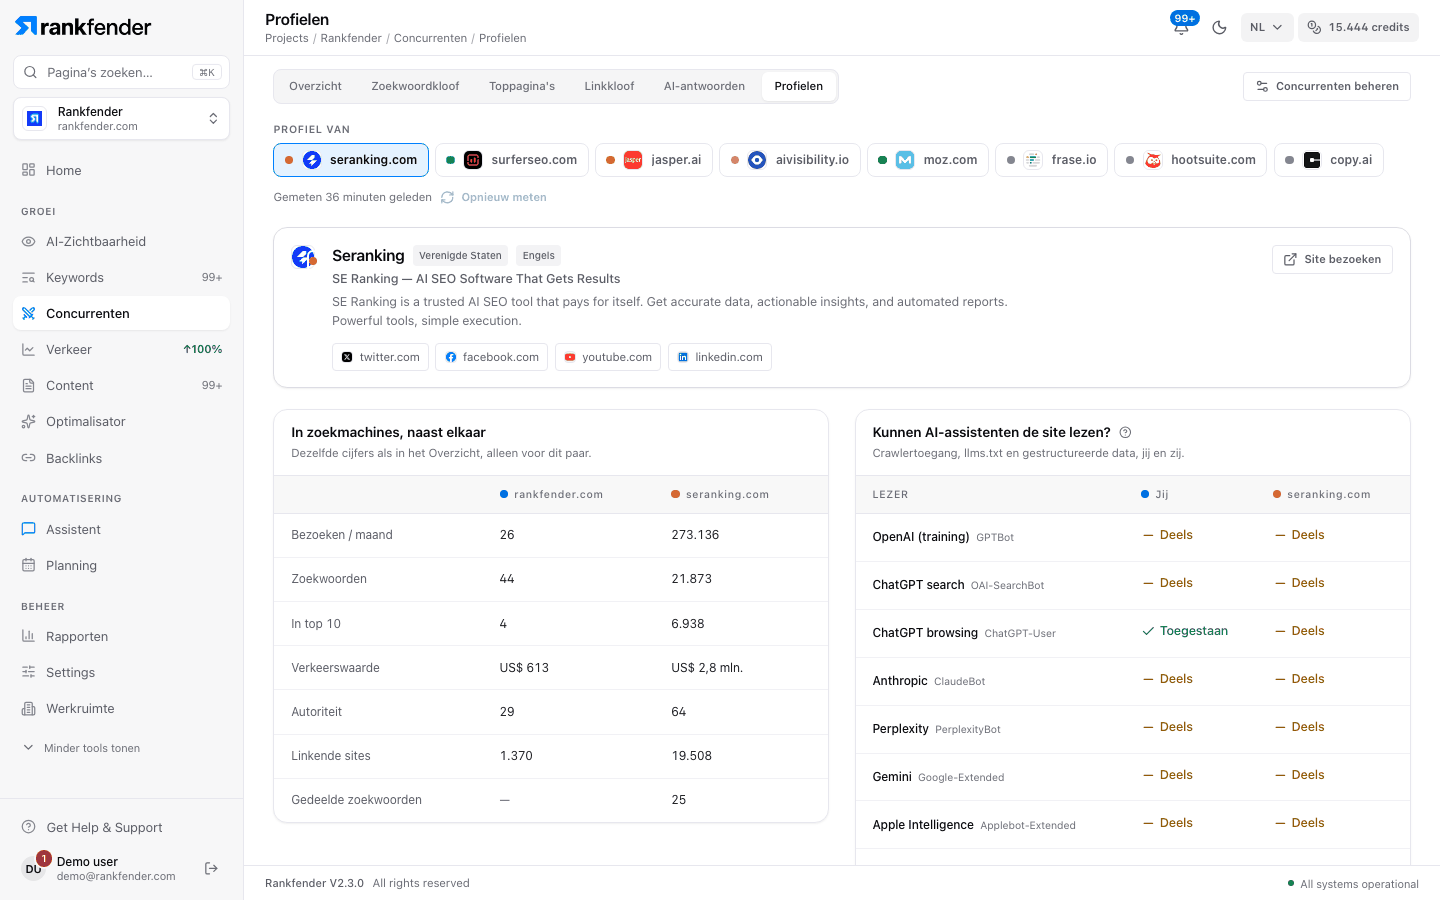
Een profiel kiezen
Kies de concurrent bij „Profiel van”, of klik op een concurrent in Overzicht › „Naast elkaar”. De eerste keer opent Rankfender zijn startpagina, leest robots.txt, llms.txt en sitemap, herkent de technologie van de site en vergelijkt die met die van jou. „Opnieuw meten” meet beide profielen opnieuw, het zijne en het jouwe.
De kop
Logo en naam, land- en taalbadges, titel en beschrijving van zijn startpagina, de socialemediaprofielen waar de site naar linkt, en „Site bezoeken”. „Site reageerde niet” betekent dat zijn startpagina geen antwoord gaf. Als Rankfender bij het opzetten van je project een korte analyse van deze concurrent schreef, zie je ook „Marktpositie”, „Prijzen”, „Sterke punten” en „Zwakke punten”.
In zoekmachines, naast elkaar
Dezelfde cijfers als in het overzicht, alleen voor dit paar: „Bezoeken / maand”, „Zoekwoorden”, „In top 10”, „Verkeerswaarde”, „Autoriteit”, „Linkende sites” en „Gedeelde zoekwoorden”. Het zijn schattingen van een leverancier van zoekdata; zie Overzicht.
Kunnen AI-assistenten de site lezen?
AI-assistenten noemen alleen sites die hun crawlers mogen lezen. Elke site zegt in zijn robots.txt welke crawlers hij toelaat. Deze kaart toont 10 AI-crawlers („Lezer”), zoals GPTBot, OAI-SearchBot, ClaudeBot en Google-Extended, met de regel die elke site op zijn startpagina toepast.
| Waarde | Wat het betekent |
|---|---|
| „Toegestaan” | De crawler mag de startpagina lezen. |
| „Geblokkeerd” | De robots.txt verbiedt het. |
| „Deels” | Sommige paden zijn toegestaan, andere geblokkeerd. |
| „Onbekend” | De robots.txt reageerde niet, dus de toegang is niet te lezen. |
Onder de crawlers: „llms.txt” („Aanwezig” of „Afwezig”), een korte gids voor AI, en de „Typen gestructureerde data” op de startpagina. Een site zonder robots.txt laat elke crawler toe. Als een kant crawlers blokkeert, meldt een notitie dat, bijvoorbeeld „Jij blokkeert N AI-crawlers — die assistenten kunnen je site niet lezen.” Om je eigen site grondig te controleren, zie Elke controle uitgelegd.
Contentmachine
Omvang en versheid volgens zijn sitemap: „Pagina's”, „Recent, 30 dagen”, „Recent, 90 dagen” en „Talen” (de taalversies die zijn startpagina opgeeft), elk met „jij: N” voor jouw site.
Gestructureerde data op hun startpagina
De schematypen op zijn startpagina, die zoekmachines en AI vertellen wat hij is. Elk type is gemarkeerd met „Jij gebruikt het ook” of „Alleen zij gebruiken het”; gemarkeerd zijn typen die hij gebruikt en jouw startpagina niet.
Gebouwd met
De technologie die op zijn site is herkend, gegroepeerd per soort (bijvoorbeeld contentsysteem, analytics, hosting). „Niets herkend.” als er niets wordt gevonden.
Let op
Crawlertoegang, llms.txt en gestructureerde data worden gelezen uit de openbare bestanden van elke site, op de dag die „Gemeten …” toont. Gestructureerde data wordt alleen op de startpagina gecontroleerd, dus een site kan op andere pagina's meer typen gebruiken. De technologieherkenning kan tools missen die geen spoor in de pagina achterlaten.